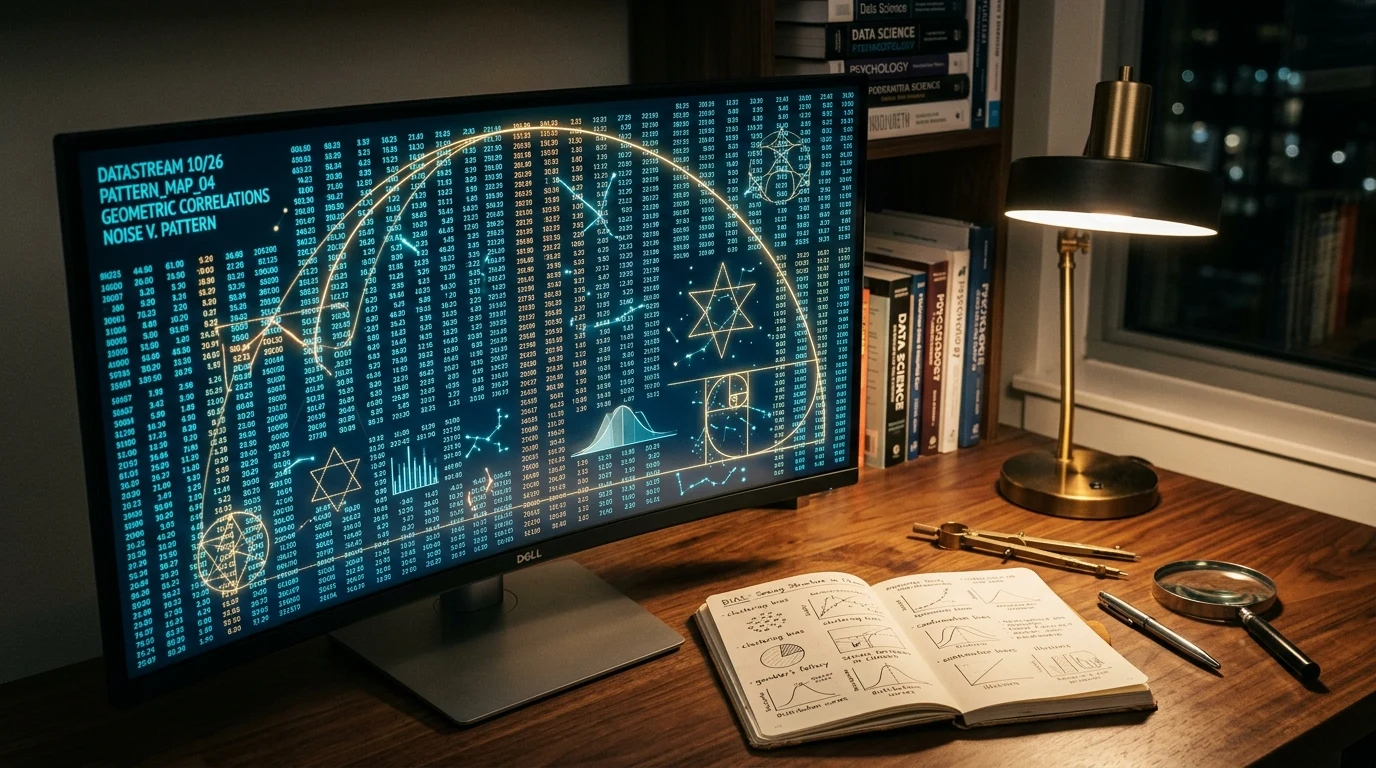
Иллюзия закономерности, или иллюзия кластеризации (clustering illusion, clustering bias), — когнитивное искажение, при котором естественные серии, скопления и промежутки в случайных данных воспринимаются как признак скрытого правила, тренда или причины. Ошибка возникает не потому, что человек «не понимает вероятность» вообще, а потому, что интуитивно ожидает от случайности слишком ровного рисунка. Настоящая случайность, напротив, нередко выглядит комковатой: в ней появляются длинные серии, пустые участки и локальные кластеры.
В психологии случайности главный практический вопрос не в том, существуют ли закономерности в принципе, а в другом: как отличить реальный сигнал от статистического шума. Один необычный фрагмент данных редко даёт ответ. Нужны размер выборки, базовая вероятность, заранее заданная гипотеза, сравнение со случайной моделью и проверка того, повторяется ли эффект на новых данных.
Почему случайность выглядит подозрительно упорядоченной
Распознавание закономерностей — одна из базовых функций восприятия. Способность быстро замечать повторения, связи и изменения полезна в обычной жизни, но у неё есть цена — ложные срабатывания. Когда данных мало, System 1, быстрая интуитивная система мышления, легко достраивает историю там, где наблюдается обычная случайная вариация. Более медленный аналитический System 2 способен проверить впечатление, но для этого нужны дополнительные данные и явный статистический критерий.
Один из ключевых механизмов — эвристика репрезентативности. Люди склонны ожидать, что небольшой фрагмент случайной последовательности должен быть похож на весь процесс. Если честная монета имеет вероятность орла 50%, то обычное подбрасывание монеты уже показывает эту проблему: последовательность «орёл — решка — орёл — решка — решка — орёл» кажется более случайной, чем «орёл — орёл — орёл — орёл — решка — решка». Но обе конкретные последовательности при независимых подбрасываниях имеют одинаковую вероятность.
Даниэль Канеман и Амос Тверски описывали связанное с этим явление как «закон малых чисел»: человеку кажется, что малая выборка должна отражать свойства генеральной совокупности почти так же хорошо, как большая выборка. Отсюда возникает нечувствительность к размеру выборки. Настоящий закон больших чисел работает при накоплении большого числа независимых наблюдений, но не обещает ровного баланса на коротком отрезке.
С этим же связаны alternation bias и negative recency bias — ожидание слишком частого чередования исходов и ощущение, что после серии одного результата «пора» появиться противоположному. Случайная последовательность не обязана выглядеть визуально беспорядочной в каждом коротком фрагменте.
Серии, кластеры и пробелы — нормальная часть случайного процесса
Испытания Бернулли дают простой пример: при независимых повторениях каждый исход определяется своей вероятностью, но конкретная реализация процесса может содержать серии (streaks, runs) и длинные пробелы (gaps). Если бросать монету много раз, несколько орлов подряд не требуют отдельной причины. Если случайно расставлять точки на плоскости, часть точек окажется близко друг к другу, а часть пространства останется пустой.
Случайное распределение и псевдослучайные данные тоже могут визуально содержать локальные сгущения. Для пространственных событий базовой моделью часто служит распределение Пуассона или модель полной пространственной случайности. Даже при отсутствии взаимодействия между событиями такая модель порождает локальные сгущения — то, что иногда называют Poisson clumping. Визуально эти сгущения легко принять за «особую зону», хотя они могут полностью укладываться в ожидаемую дисперсию случайного процесса.
Вариабельность и дисперсия — не помехи, которые случайный процесс обязан «сгладить», а его нормальные свойства. На коротком участке статистический шум способен выглядеть структурированно даже тогда, когда генератор полностью случаен.
Поэтому оценка кластера без случайного baseline ненадёжна. Правильный вопрос звучит не «похоже ли это на закономерность?», а «насколько часто такой рисунок возникает, если никакой закономерности нет?»
Лондонские бомбардировки: классический пример пространственной случайности
Во время Второй мировой войны жители Лондона замечали участки, куда попадало несколько немецких летающих бомб, и участки, почти не затронутые ударами. Возникало естественное предположение, что попадания V-1 образуют кластеры. В популярном изложении рядом часто упоминаются и V-2, однако классический статистический расчёт Р. Д. Кларка относился именно к V-1.
В работе An Application of the Poisson Distribution 1946 года R. D. Clarke исследовал выбранный район южного Лондона площадью 144 км², разделённый на 576 квадратов по 0,25 км². Число попаданий по квадратам хорошо согласовывалось с распределением Пуассона. То, что невооружённому глазу казалось «сгущениями», в пределах выбранной области не требовало гипотезы о прицельном наведении на отдельные кварталы.
У этого примера есть важное ограничение. Позднейшие разборы показывают, что плотность попаданий по всему Лондону не была однородной; классическая модель работала для ограниченной южной области, где предположение примерно постоянной интенсивности было приемлемо. Это хороший урок: не только наличие кластера, но и выбор границ, масштаба и фоновой модели влияет на вывод.
«Горячая рука» в баскетболе: где заканчивается иллюзия и начинается реальный эффект
Другой известный сюжет — hot hand, «горячая рука». Игрок, попавший несколько раз подряд, кажется вошедшим в особое состояние; серия попаданий воспринимается как значимее, чем чередование попаданий и промахов, поэтому болельщики, тренеры и сами спортсмены могут ожидать повышенной вероятности следующего попадания.
В 1985 году Томас Гилович, Роберт Валлоне и Амос Тверски опубликовали работу The Hot Hand in Basketball: On the Misperception of Random Sequences. Они анализировали броски Philadelphia 76ers, штрафные Boston Celtics и контролируемый эксперимент с университетскими баскетболистами Cornell. Авторы не нашли ожидаемого положительного эффекта предыдущего попадания и связали веру в серии с ошибочным восприятием случайных последовательностей.
Позднее картина стала сложнее. В 2018 году Joshua B. Miller и Adam Sanjurjo показали, что стандартный способ измерения зависимости после серии содержит streak-selection bias — смещение, возникающее из-за отбора позиций после успешных серий в конечной последовательности. Это частный случай проблем selection bias и finite-sample bias. После коррекции авторы получили свидетельства в пользу реального hot-hand effect в данных, которые прежде использовались против него.
Отсюда следует принципиальная граница: убеждение в «горячей руке» может быть когнитивным искажением, но само существование серий не доказывает, что эффект вымышлен. Иллюзия кластеризации предупреждает против поспешного вывода, а не запрещает обнаруживать настоящие зависимости.
Чем иллюзия закономерности отличается от похожих когнитивных ошибок
| Понятие | Что происходит | Ключевое отличие |
|---|---|---|
| Апофения / patternicity | Человек находит смысл или связь между несвязанными событиями. | Более широкое понятие; иллюзия кластеризации — один из способов увидеть ложный паттерн. |
| Парейдолия | В неоднозначном образе узнаётся знакомая форма: лицо в облаках, фигура в пятнах, созвездие в случайном расположении звёзд. | Обычно относится к распознаванию знакомого образа, а не к статистической серии. |
| Ошибка игрока (gambler’s fallacy) | После серии одного исхода ожидается противоположный: «пять раз выпал орёл — теперь должна быть решка». | Из серии ошибочно выводится скорый разворот. |
| Hot-hand belief | После серии успехов ожидается продолжение успеха. | Из серии, наоборот, выводится продолжение; реальный hot-hand effect нужно проверять отдельно. |
| Иллюзорная корреляция | Две переменные кажутся связанными сильнее, чем показывают данные. | Ошибка касается связи между признаками, а не только расположения событий. |
| Ошибка техасского снайпера (Texas sharpshooter fallacy) | Сначала замечается удачное скопление, затем вокруг него проводится «мишень» и придумывается объяснение. | Критерий, границы или гипотеза выбираются после просмотра данных. |
| Ошибка подтверждения | Запоминаются попадания в ожидание, а противоречащие случаи недооцениваются. | Поддерживает уже выбранную интерпретацию кластера. |
К ложной уверенности могут добавляться эвристика доступности, когда яркие серии легче вспоминаются; hindsight bias, когда случайное событие после факта кажется предсказуемым; narrative fallacy, превращающая шум в убедительную историю; overconfidence, усиливающая доверие к собственной интерпретации; игнорирование базовой частоты и иллюзия контроля, из-за которой случайный результат приписывается собственным действиям.
Где иллюзия закономерности особенно дорого обходится
Фондовый рынок и инвестиции
На фондовом рынке короткая серия, в которой цены акций растут, может восприниматься как новый устойчивый тренд, а несколько удачных решений инвестиционного менеджера — как доказательство исключительного мастерства. Та же ошибка возможна при сравнении результатов отдельных взаимных фондов: прошлый кластер высокой доходности без поправки на риск и размер выборки не гарантирует устойчивого преимущества. В поведенческих финансах это особенно важно, потому что инвесторы ежедневно имеют дело со смесью сигнала и шума.
Та же проблема возникает при визуальном техническом анализе. Фигуры вроде «головы и плеч» или «двойного дна» могут быть полезны только тогда, когда правила их определения заданы достаточно точно и прогностическая способность проверена на независимых данных. Если паттерн выбирают после просмотра графика, риск ошибки техасского снайпера и множественного тестирования резко возрастает.
Медицина и географические «очаги»
Раковые кластеры и другие локальные скопления заболеваний вызывают обоснованную тревогу, но сам факт близкого расположения нескольких случаев ещё не доказывает общий источник. Нужно учитывать численность населения, возрастную структуру, базовую заболеваемость, длительность наблюдения и заранее определённые географические границы. Если искать «подозрительный район» среди множества районов, какой-то экстремальный кластер может возникнуть случайно.
Это не означает, что реальные экологические или эпидемиологические очаги не существуют. Задача статистики — не отвергать кластер, а проверить, насколько он отличается от ожидаемого фона и есть ли правдоподобный причинный механизм.
A/B-тестирование и продуктовая аналитика
В A/B-тесте конверсия может несколько дней подряд расти или падать просто из-за случайной вариации. Если остановить эксперимент в момент красивой серии, вероятность ложного вывода увеличивается. A/A-тестирование, где сравниваются эквивалентные варианты, наглядно показывает, насколько «убедительные» временные разрывы способны появляться без реального эффекта.
То же происходит с продуктовыми метриками, email-кампаниями и редизайн сайта как событие. Пик конверсии после изменения интерфейса ещё не устанавливает причинность: могли измениться источник трафика, день недели, рекламная кампания, сезонность или состав аудитории.
Азартные игры, спорт и бытовые решения
В казино, лотереях и онлайн-играх ошибка игрока заставляет принимать серию прошлых исходов за подсказку о следующем независимом событии. В спорте похожая серия может породить веру в «форму» игрока, хотя часть наблюдаемого эффекта объясняется дисперсией и регрессией к среднему. На рынке недвижимости несколько быстрых продаж в одном квартале могут выглядеть как начало устойчивого бума, хотя выборка ещё слишком мала.
Даже нейтральные примеры показывают тот же механизм: серия одинаковых ответов в тестах вроде SAT, группа ярких звёзд на ночном небе, несколько метеоров в одном секторе во время метеорного потока или плотная группа точек на графике кажутся менее случайными, чем более равномерный рисунок. Впечатление само по себе не является статистическим тестом.
Одномерная и двумерная случайность воспринимаются по-разному
Иллюзию кластеризации изучают не только на последовательностях чисел или подбрасываниях монеты. В 2020 году Ольга Стерник под руководством Тадамасы Савады в НИУ ВШЭ исследовала восприятие случайности в 1D- и 2D-стимулах. Работа охватывала восприятие и генерацию случайной информации. Психофизический эксперимент с двумерными изображениями и точечными графиками показал, что иллюзия способна заметно влиять на оценку случайности распределения точек; в некоторых условиях значение имело и число точек.
Это важно для реальных данных: человек оценивает не только числовые ряды, но и карты, диаграммы рассеяния, тепловые карты, географические очаги и визуальные панели аналитики. Чем сильнее решение зависит от «рисунка на глаз», тем важнее сравнение с формальной нулевой моделью.
Как проверить, реальна ли замеченная закономерность
- Предварительно сформулировать гипотезу — до просмотра результата. Нужно заранее определить, что считается серией, кластером или эффектом. Постфактум подобрать границу, период и метрику почти всегда легче, чем честно предсказать их заранее.
- Задать нулевую гипотезу. Она описывает мир, в котором специального эффекта нет. Для монеты это могут быть независимые испытания с фиксированной вероятностью, для пространственных событий — подходящая модель Пуассона, для эксперимента — отсутствие различий между вариантами.
- Проверить базовую вероятность. Редкий исход выглядит впечатляюще только относительно правильного base rate. Без базовой частоты нельзя оценить, действительно ли событие необычно.
- Оценить размер выборки и дисперсию. На маленькой выборке разброс велик. Увеличение выборки снижает риск принять обычную вариацию за стабильное свойство процесса.
- Проверить независимость событий. Ошибка игрока применима именно там, где исходы независимы. Если события действительно влияют друг на друга, модель должна учитывать зависимость.
- Сравнить наблюдение со случайным baseline. Полезен метод случайных симуляций (random simulation) и Monte Carlo simulation: генерируется множество наборов данных при отсутствии эффекта и проверяется, насколько часто возникает нечто столь же «подозрительное».
- Учесть множественное тестирование. Если одновременно просмотреть десятки метрик, временных окон, сегментов или районов, вероятность хотя бы одного ложноположительного результата растёт.
- Разделять статистическую и причинную связь. Корреляция или красивый кластер не устанавливают причинность. Нужны механизм, альтернативные объяснения и, когда возможно, экспериментальный контроль.
- Искать опровергающие данные. Ошибка подтверждения ослабевает, если специально искать периоды и наблюдения, где предполагаемый паттерн не работает.
- Проверить эффект на новых данных. Устойчивая закономерность должна переживать репликацию, другой период, другую выборку или заранее определённый holdout-набор.
Для научных и продуктовых экспериментов полезны предрегистрация гипотезы, заранее выбранная метрика и критерий остановки. Статистическая значимость сама по себе не доказывает практическую важность эффекта, особенно если проверялось много гипотез. Полезны expected variation bands — ожидаемые диапазоны случайных колебаний, comparison with null model, A/A-проверки и контроль множественных сравнений. Всё это повышает статистическую грамотность решения и уменьшает риск подгонки временного или пространственного окна под уже увиденный результат.
При статистической проверке остаются два разных риска. Ошибка I рода (false positive) — признать закономерность существующей, когда её нет. Ошибка II рода (false negative) — не обнаружить реальный эффект. Борьба с иллюзией кластеризации не должна превращаться в автоматическое отрицание любого паттерна: чрезмерный скептицизм тоже способен скрыть сигнал.
Почему «регрессия к среднему» часто усиливает ощущение скрытой причины
Экстремальные значения нередко сменяются более обычными просто потому, что крайние результаты частично состоят из случайного компонента. Это регрессия к среднему. После необычно плохой недели продажи могут вырасти без какого-либо вмешательства; после рекордного матча результат спортсмена может снизиться без «потери формы».
Если действие было предпринято именно в момент экстремума, естественный возврат легко приписать этому действию. Так появляется ложная причинность: «после изменения стало лучше, значит, изменение помогло». Чтобы отделить эффект вмешательства от регрессии к среднему, нужен контроль, достаточная история наблюдений или экспериментальный дизайн.
Когда кластер всё-таки стоит воспринимать всерьёз
Случайность может создавать впечатляющие скопления, но это не значит, что любой кластер бессмыслен. Оснований считать закономерность реальной становится больше, когда одновременно выполняются несколько условий:
- эффект заметно превышает диапазон, ожидаемый при случайной модели;
- критерий был задан заранее, а не выбран после просмотра результата;
- выборка достаточно велика для требуемой точности;
- результат повторяется на независимых данных;
- существует правдоподобный механизм, объясняющий зависимость;
- эффект сохраняется после учёта альтернативных факторов и множественных сравнений;
- модель обладает не только объяснительной, но и прогностической способностью.
Именно здесь проходит граница между сигналом и статистическим шумом. Настоящая закономерность должна выдерживать попытку её опровергнуть.
Короткий алгоритм против иллюзии закономерности
Если в данных внезапно обнаружился «очевидный» паттерн, полезно пройти пять вопросов:
- Как выглядели бы данные, если бы никакого эффекта не было?
- Достаточно ли наблюдений, чтобы отличить сигнал от случайной вариации?
- Были ли правило, границы и период определены до того, как стал виден результат?
- Сохраняется ли эффект при другом масштабе, временном окне или на новой выборке?
- Есть ли независимый механизм, который объясняет результат лучше, чем случайность?
Эти вопросы одинаково полезны при оценке серии бросков, инвестиционного графика, географического очага, результатов научного исследования, A/B-теста или собственных повседневных наблюдений.
Ключевые исследования
- Amos Tversky, Daniel Kahneman — Belief in the Law of Small Numbers (1971): формулировка идеи о переоценке репрезентативности малых выборок.
- Amos Tversky, Daniel Kahneman — Subjective Probability: A Judgment of Representativeness (1972): развитие связи между субъективной вероятностью и эвристикой репрезентативности.
- R. D. Clarke — An Application of the Poisson Distribution (1946): статистический анализ попаданий V-1 в южном Лондоне.
- Thomas Gilovich, Robert Vallone, Amos Tversky — The Hot Hand in Basketball: On the Misperception of Random Sequences (1985): классическая работа о восприятии серий в баскетболе.
- Thomas Gilovich — How We Know What Isn’t So: The Fallibility of Human Reason in Everyday Life (1991): разбор того, как люди формируют и поддерживают ошибочные убеждения.
- Joshua B. Miller, Adam Sanjurjo — Surprised by the Hot Hand Fallacy? A Truth in the Law of Small Numbers (2018): выявление streak-selection bias и пересмотр части классических выводов о hot hand.
- Ольга Стерник, Тадамаса Савада — исследование НИУ ВШЭ «Иллюзия кластеризации» (2020): восприятие случайности в одномерных и двумерных стимулах и оценка точечных распределений.
Итог
Иллюзия закономерности возникает, когда локальная структура случайных данных воспринимается как доказательство отдельной причины. Мозг ждёт от случайности равномерности, хотя реальные случайные процессы естественно создают серии, кластеры и пустоты. Особенно легко ошибиться на малых выборках, при визуальном поиске паттернов и после просмотра большого числа вариантов.
Надёжная защита строится не на попытке «не видеть закономерности», а на проверке: базовая частота, размер выборки, нулевая гипотеза, независимость событий, случайная симуляция, контроль множественных сравнений, поиск альтернативных объяснений и повторение результата на новых данных. Закономерность заслуживает доверия не потому, что выглядит убедительно, а потому, что выдерживает сравнение со случайностью.